
第 13 章 出事了先找证据
第五部分 和真实世界打交道 · 正文初稿
这一章是初稿,还会修改。
本章要回答
线上出问题怎么查;接手别人的代码怎么下手;复盘写什么。
示例项目推进到哪
写一份事故复盘。
先说结论
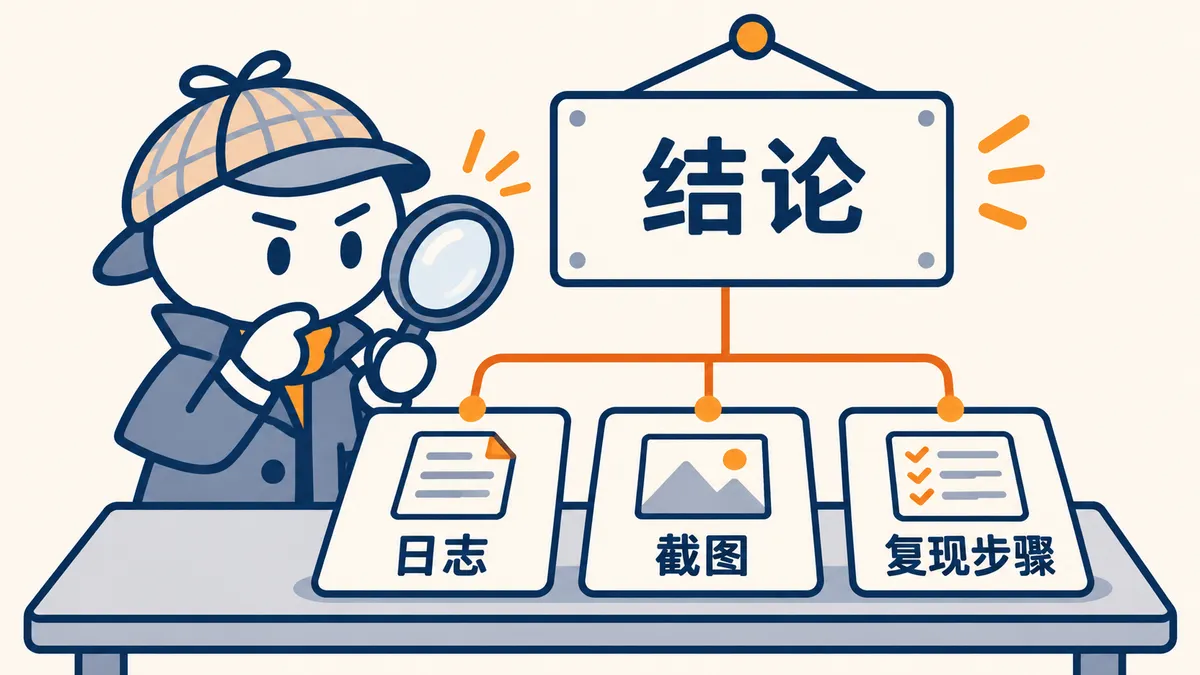
线上出问题时,最容易犯的错是先给问题起名字,再去找支持这个名字的证据。这一章讲反过来的做法:先列出能确认什么、不能确认什么,再沿着请求和数据经过的路径一层一层补证据,最后才下结论。
读完你能做三件事:
- 线上出错时,按顺序查,并写出一份「证据边界」;
- 接手别人的项目,或者面对一个已经乱掉的现场时,先保护现场,再动手;
- 修完以后写一份复盘,让同样的问题不再出现。
验收标准有三条:每个结论背后都有证据;修完有验证;复盘里写了防止再发生的具体动作。
一次 502:域名打不开,应用其实好好的
先看一分钟动画,再读下面的细节:
陪玩系统部署到服务器那天,后台打不开。从外面访问域名和健康检查接口,都返回 502 Bad Gateway。
先解释两个词。反向代理是站在服务器门口的一层程序,外部请求先到它,再由它转给后面的应用,HTTPS 证书通常也装在它这里。502 的意思是:请求已经到了这个代理,代理去找后面的应用,没找到,或者应用没回应。所以 502 说明问题在「代理到应用」这一段附近,但没说是哪一种。
当时我按这个顺序查。
先修部署本身。 第一次执行部署命令时少了一个空格,-d 和 --build 连在了一起,Docker 直接报参数错误。改正后再跑,又卡在拉取数据库和缓存镜像超时,服务器连不上 Docker 的官方镜像仓库。给服务器配了镜像源,重启 Docker。中间配置文件写入不完整,Docker 重启失败,重新写对以后才恢复。修完这些,数据库、缓存、应用三个容器都显示健康。
再在服务器本机验应用。 在服务器上直接请求应用的健康检查:
curl -i http://127.0.0.1:3000/api/health → HTTP/1.1 200 OK这一步很关键。它证明应用本身、数据库、缓存都正常。问题被缩小到了「外面进不来」。
再查域名指向。 我在本地查域名解析,看到的是一个旧地址,和文档里记录的服务器地址对不上。这时候很容易下结论:域名指错了。
我没有马上去改。先去查了权威 DNS,也就是域名解析的最终记录,它不受本地缓存影响。结果是域名已经指向正确的服务器,本地看到的旧地址是缓存。域名这条线排除。如果当时顺着第一个猜测去改解析,会白改一次,还要等它生效,问题照旧。
最后查代理到应用这一段。 三条证据摆在一起:本机请求 200,域名访问 502,域名指向正确。剩下的只可能是代理没连上应用。
一看应用的端口绑定,原因出来了。应用只绑在 127.0.0.1:3000,意思是只接受服务器本机发来的请求。反向代理自己跑在另一个 Docker 容器里,容器里的 127.0.0.1 指的是容器自己,不是服务器。代理去找「自己的」3000 端口,当然找不到。
修复分两步:把应用的绑定地址改成 0.0.0.0,让它接受服务器网络上的请求;在代理里把转发目标改成服务器的内网地址加 3000 端口。中间试过 Docker 的默认网桥地址,还是 502,换成内网地址才通。之后申请 HTTPS 证书,开启强制跳转。
最后从外部验证了四条:HTTPS 健康检查返回 200;HTTP 自动跳到 HTTPS;首页跳到后台入口;证书校验正常。
排查期间还冒出一个问题:SSH 登录服务器失败。日志显示请求到了服务器,但握手出错。我把它单独记了下来,没有混进这次故障。后台打不开和 SSH 连不上是两件事。前者已经有完整的证据链,后者另开一项去查。
这次排查里起作用的是三个习惯:
- 每一层单独验证。 本机能通、域名指向对、代理连不上,三条证据合在一起才定位到问题。
- 第一眼看到的异常,先查是不是干扰项。 本地显示旧地址,查了权威记录才知道是缓存。
- 同时出现的问题分开处理。 SSH 的问题如果混进来,会把排查拖进另一条岔路。
先写证据边界
另一个例子更小,但更能说明方法。完整记录在 /cases/evidence-first-debugging。
一个完工结算页面,同一个任务要上传两张证明图:开始一张,结束一张。用户反馈:第二张传上去以后,第一张不见了。
最顺口的判断是「第二次上传把第一次覆盖了」。这句话比证据走得快。
这时候能确认的只有三件事:
- 第一次上传后,第一张图曾经可见;
- 第二次上传后,第一张图不可见;
- 两次之间有状态变化。
不能确认的有一串:上传接口是不是真的删了第一张;第二次接口返回的数据是不是只有第二张;前端是不是用第二次的返回值替换了整个状态;第一张图有没有存进数据库;会不会只是页面没画出来,数据其实还在。
把这两张清单写下来,就是证据边界。它防止你把页面现象直接当成根因,然后去改一个没坏的地方。
接下来沿着数据经过的路径,一层层查:
选择文件 → 上传请求和响应 → 页面里的图片状态 → 提交结算的请求
        → 服务端写入 → 数据库 → 刷新后重新读取 → 页面显示
每一层都有一个具体的东西要看:
| 在哪一层发现异常 | 更可能是什么问题 | 要补的证据 |
|---|---|---|
| 第二次上传前,第一张已经不在状态里 | 页面初始化出了问题 | 第二次上传前的状态记录 |
| 第二次响应后,第一张从状态里消失 | 前端用新返回值整体替换了旧状态 | 请求响应,以及前后状态对比 |
| 提交请求里没有第一张的地址 | 提交前数据组装错了 | 浏览器开发者工具里的请求内容 |
| 提交请求有两张,数据库只有一张 | 后端更新逻辑覆盖了字段 | 服务端日志、数据库记录 |
| 数据库有两张,刷新后只显示一张 | 读取或显示出了问题 | 读取接口的响应、页面显示条件 |
证据没补齐之前,结论只能写到这里:
已确认:第二次上传完成后,第一张证明图在页面上不可见。根因尚未确认。下一步对比第一次上传后的状态、第二次上传的响应、提交请求的内容、服务端日志和数据库记录,逐层确定是状态被覆盖、提交时丢失、后端覆盖还是显示问题。
这句结论没有假装已经找到根因,但把下一步要补什么说清楚了。排查的价值不在于最快给问题起名字,而在于每一次检查都能排除一种可能。
接手别人的代码:先保护现场
接手别人的项目,或者接手一个已经被弄乱的现场,第一件事不是改代码。
我经历过一次事故,完整记录在 /cases/worktree-baseline-incident。先解释一个词:worktree 是 Git 的一个功能,允许同一个仓库在电脑里同时开好几个工作目录,每个目录检出不同的分支。目录名是人起的,不代表里面是哪个分支。
那是一个在线下单系统,本地有好几个工作目录。其中一个目录名带着 main,大家就默认它是主线。实际上它检出的是电脑里一份很旧的本地 main,比 GitHub 上最新的主线少了 81 个提交。另一个名字带 main 的目录,检出的其实是功能分支。实际做功能的那个工作区,检出的也是功能分支,有自己的提交,但不包含主线上的新变化。
大家以为自己在处理主线,实际手里的代码来自不同分支、不同时间点。用旧主线恢复出来的代码,缺了主线上已有的改动;功能分支又把还没正确合并的东西带了进来;目录里没提交的改动再被覆盖掉。结果是下单不能用,后台大量功能回退,整个系统几乎瘫痪。
回头看,没有哪条命令敲错。出事的原因是几个本来要分开的东西被当成了一回事:
- GitHub 上的 main,是远端主线;
- 功能分支,是某一项工作的路线;
- worktree,是电脑里的工作目录;
- PR,是远端的审核记录。
它们要互相对应,但不能互相冒充。
事后第一件事是只读盘点,什么都不删:不删目录,不删分支,不清理未跟踪的文件,不重置代码,不用一个目录覆盖另一个。盘点结果是:现场有 15 个工作目录;功能主目录有 14 条未提交的改动;恢复目录有 36 条;还有一个目录已经不存在,Git 却还记着它。这些数字记下来以后,才知道哪些东西已经保存,哪些还只在现场。
现在接手任何项目,我都按这个顺序:
- 只读盘点。 GitHub 上最新的 main 是哪个提交;本地有哪些分支和工作目录,各自检出什么;有没有未提交的改动。先看,不动。
- 认清主线。 以 GitHub 上最新的 main 为准,不以目录名为准,也不以电脑里的旧 main 为准。
- 保存现场。 未提交的改动单独登记、单独保存,不默认它们已经在某个分支里。
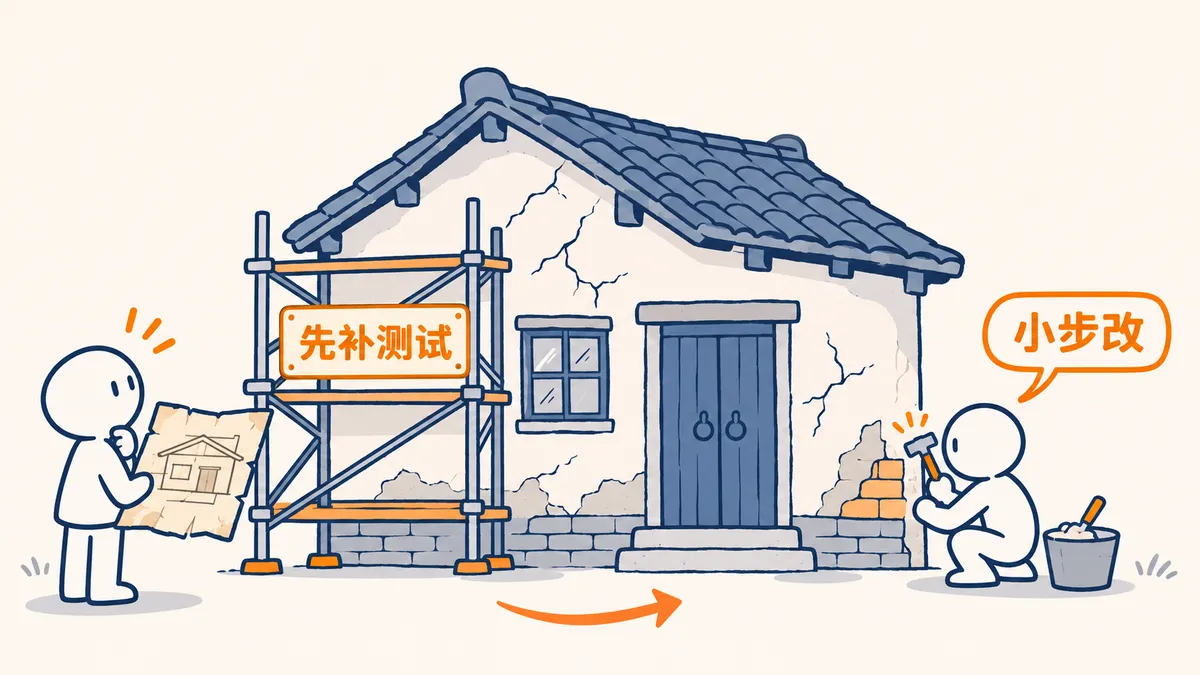
- 先跑起来。 照 README 在自己电脑上跑通。跑不通的步骤记下来,这就是第一份交接问题清单。
- 先锁住现有行为。 要改哪一块,先让 AI 给这一块补一条测试,记下它现在的行为。改完以后这条测试还能过,才说明没把别的地方改坏。
- 小步改,每一步都能退回。 一次只改一件事,开分支,提 PR。
- 清理放到最后。 代码已提交并推送、PR 有结果、材料交接完,才删工作目录。
还有一类判断容易出错:看到一个状态提示,就当成要立刻行动。我在一个开源项目里看到别人的 PR 落后于主线,就提醒作者马上 rebase,也就是把分支挪到最新的主线上重新接一遍。维护者很快指出:这一片的 PR 还在排队,彼此会冲突,现在 rebase,前一个合并以后还得再做一次;轮到它时,维护者会通知作者。技术状态我看对了,处理时机和提要求的身份判断错了。完整经过在 /cases/pr-rebase-timing-incident。
接手别人的项目也一样。看到「分支落后」「依赖过期」「代码风格不统一」,先问三个问题:现在处理它,能推动当前的任务吗?这件事该由谁决定?现在做,会不会过一会儿又要重做?答案不清楚,就先记下来,不动。
写复盘
问题修完,写一份复盘。复盘写给下一个人看,也写给下一次的自己看,要让人看见现场、误判、证据和修正过程。它不是检讨书,也不用写成「最后成功了」的总结。
我写复盘按这个结构:
- 发生了什么:现象、影响范围、持续多久。
- 当时掌握了哪些证据。
- 做过哪些判断,哪些后来被推翻了。
- 根因和修复。
- 怎么验证修好了。
- 怎么防止再发生:具体改了什么规则、加了什么检查。
有一条纪律:只写当时真实存在的东西。当时没有做过的判断、没有过的动机,事后不要补写进去。
下面用餐厅后台做一次演练。这个项目的前端和后端分开发布,前端打包时要通过环境变量告诉它后端地址。如果没设置,前端会退回去找本机的开发地址,这个地址只在开发者自己的电脑上有效。这是上线时很容易出现的问题,拿它写一份复盘示范,时间和数字都是演练用的:
事故复盘:订单页和经营首页加载失败(演练)

一、发生了什么
- 某日 11:40 发布前端新版本后,店员反馈订单页一直转圈,经营首页没有数据
- 影响:所有店员无法下单,持续约 25 分钟,期间改用纸质点单
- 12:05 回滚到上一个版本后恢复

二、当时的证据
- 后端健康检查返回 200,后端正常
- 浏览器开发者工具里,页面请求都发往本机开发地址,全部失败
- 发布记录显示,本次发布由一个新建的部署项目执行

三、判断过程
- 先怀疑后端挂了 → 健康检查 200,推翻
- 再怀疑数据库连接 → 后端日志没有错误,也没有新请求进来,推翻
- 请求根本没到后端 → 请求地址是本机开发地址,
  确认是前端打包时缺少后端地址变量

四、根因与修复
- 根因:新建的部署项目没有配置后端地址变量,前端退回到开发默认值
- 修复:补上变量,重新构建并发布

五、验证
- 线上订单页加载正常,下了一笔测试单并取消
- 浏览器里看到请求发往正式后端地址

六、防止再发生
- 构建脚本加检查:生产构建时后端地址变量为空,直接失败,不允许发布
- 发布后自动请求一次订单接口,失败就告警(见第 8 章)
- 上线检查清单加一项:发布后打开订单页,实际下一单
注意第三部分。被推翻的判断要留着。它告诉下一个人这两条已经查过了,也告诉你自己第一反应容易往哪里偏。
第六部分最重要。「以后注意」不算防止再发生。要落到一个具体的检查、一条规则或一个自动动作上,下次不靠人记得。
这一步交给 AI 做什么
AI 很擅长读日志、翻代码、复现问题,也很擅长在证据不足时编出一个听起来合理的原因。所以给它的任务要先限定顺序:先证据,后结论;先分析,后动手。
排查时可以这样写:
线上出现问题:[现象,越具体越好:哪个页面、什么操作、什么时间、谁遇到]。
请按下面的顺序做,每一步做完停下来给我看:
1. 写出证据边界:目前能确认什么,不能确认什么。
2. 列出从用户操作到数据库、再回到页面经过的每一层,
   说明每一层要看什么日志或记录来判断它是否正常。
3. 收集这些证据。只读:查看日志、请求、数据库记录,不修改任何东西。
4. 根据证据给出最可能的原因,说明哪条证据支持它,还有哪些可能没排除。
5. 写一个能复现问题的测试或操作步骤,确认它在当前代码上会失败。
6. 修复,让这个测试通过,并跑完已有的全部测试。
不要删除文件,不要重置分支,不要修改生产数据。
接手项目时:
这是我刚接手的项目。请只读盘点,不修改任何东西:
1. GitHub 上最新的 main 是哪个提交,本地 main 和它差多少;
2. 本地有哪些分支和工作目录,各自检出什么分支,有没有未提交的改动;
3. 照 README 能不能跑起来,哪一步失败;
4. 有哪些测试,现在能不能全部通过;
5. 需要哪些环境变量,只列名字,不要输出值。
最后整理成一张表。
写复盘时,把排查过程的对话、日志片段和修复的 PR 给 AI,让它按上面六段结构整理。整理完你逐条核对两件事:有没有把当时并不存在的判断写进去;「防止再发生」是不是落到了具体动作上。
你要判断和验收的
- [ ] 下结论之前,写过证据边界:能确认什么,不能确认什么。
- [ ] 结论背后至少有一条直接证据,比如日志、请求、数据库记录或命令输出,不只是推测。
- [ ] 每一层单独验证过;第一眼看到的异常,查过它是不是干扰项。
- [ ] 同时出现的几个问题,分开记录、分开处理。
- [ ] 修复前有能复现问题的测试或步骤;修复后它通过了,已有测试也全部通过。
- [ ] 在线上按真实操作验证过一次,不只看本地。
- [ ] 接手项目时先做了只读盘点,未提交的改动已单独保存,没有删除、重置或覆盖任何东西。
- [ ] 复盘里写了被推翻的判断。
- [ ] 「防止再发生」落到了具体的检查、规则或自动动作上。
这一步谁来做
| 交给 AI 的 | 你要判断和验收的 |
|---|---|
| 让 AI 收集日志、复现问题、给出修复。 | 先有证据再下结论;修完验证,写下怎么防止再发生。 |
相关阅读
上一章:第 12 章 报价、排期与需求变更 · 下一章:第 14 章 交付、验收与维护