
第 7 章 第一天就上线
第三部分 上线并稳住 · 正文初稿
这一章是初稿,还会修改。
本章要回答
先把最小版本放到线上;本地、测试、生产怎么分;密钥为什么不能进仓库;Git 怎么保住每一步;以后怎么自动发布。
示例项目推进到哪
餐厅后台部署到正式域名,合并后自动发布。
读完这一章,你能把餐厅后台的最小版本放到公网上,拿到一个别人能打开的地址。你能分清本地、预览、生产三套环境,判断哪些配置是密钥、该放在哪里。你还能让每次合并后自动发布,发错了能退回去。
Git、分支、PR、GitHub Actions 和 Secrets 的具体操作,GitHub 入门小课 已经讲过。本章不再教命令,只讲你要做的判断和验收。
为什么第一天就上线
先看一分钟动画,再读下面的细节:
我在一场 15 人的线下聚会上带大家动手。所有带电脑、实际参与的人,都在 3 小时内从零做出了一个自己的小程序。有几个人当场就往上线推进,提交了备案申请。
这里要分清几个状态。小程序从写完到有人能用,要依次经过编译、预览、上传、提交审核、发布。能在开发者工具里运行,只走到了第二步。提交了备案申请,也不等于备案通过。那天大家证明的是:把第一版砍得足够小,3 小时能做出一个能跑、能验的东西。离上线还有好几步。
后面每一步都会冒出新问题:账号主体、服务类目、备案、平台审核。网站和后台系统也一样:域名、HTTPS、环境变量、数据库连接。这些问题,在你自己电脑上一个都不会出现。
所以我主张第一天就上线。理由有两个。
第一,部署问题越早暴露越便宜。第一天上线时,项目里只有一个页面,出了问题只有几个可能的原因。等功能全做完再部署,所有部署问题一起冒出来,还和业务代码搅在一起。
第二,上线给你最清楚的反馈。一个人能一直做下去,靠的是做完一件事很快看到结果。反馈太慢、信号太乱,人就容易停下来。一个能发给别人的线上地址,就是最清楚的信号:发出去,有人打开,有人告诉你哪里不对。
餐厅后台的部署说明里,专门写了一条只有线上才会出的问题。前端构建时要配一个变量,告诉它后端 API 在哪。漏配了,前端会退回默认值,也就是本机的 localhost:8787。在你自己电脑上,后端正好跑在这个地址,一切正常。部署到线上以后,用户的浏览器会去访问用户自己电脑上的 8787 端口,什么也拿不到。这种错,不部署就发现不了。
第一天上线的,是最小版本:一个页面,一条走得通的路径,连上真实的数据库。功能少没关系,先把路铺通。
放在哪:选一种部署形态
部署要回答三个问题:代码在哪里运行,用户从什么地址进来,出了问题怎么找到版本、怎么恢复。
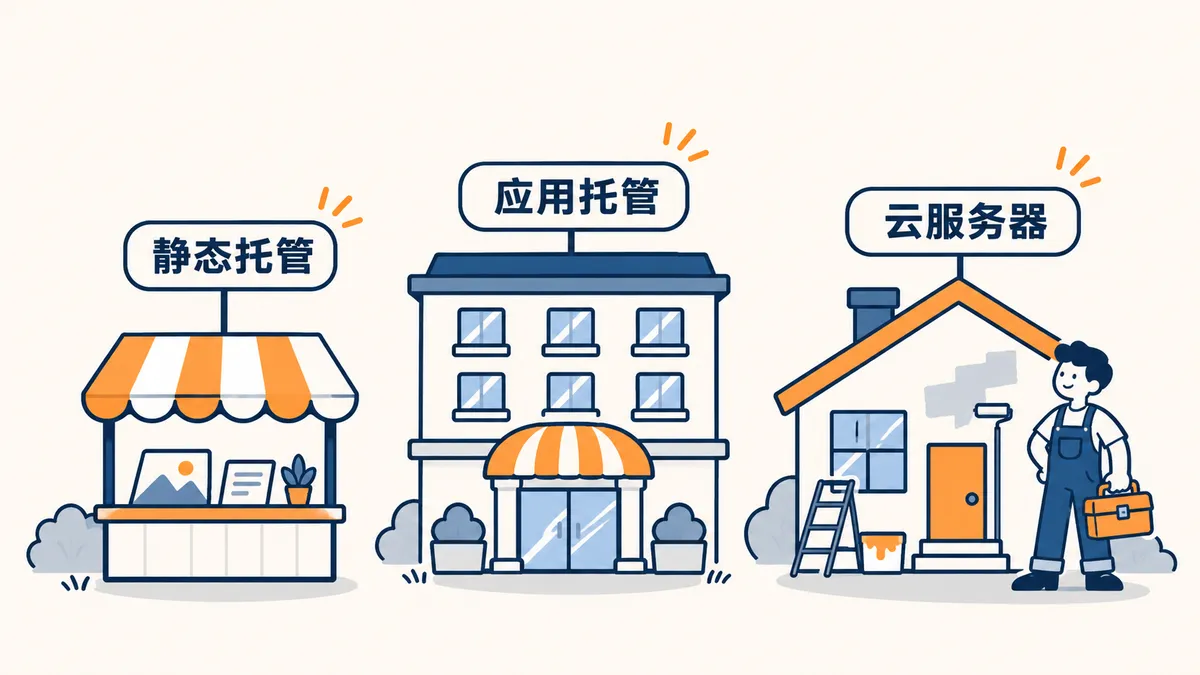
按你要管多少东西,常见的有四种:
| 形态 | 你要管什么 | 典型平台 | 适合 |
|---|---|---|---|
| 静态托管 | 前端构建产物、域名 | Vercel、Netlify、Cloudflare Pages、GitHub Pages | 官网、文档站、纯前端应用 |
| 应用托管 | 代码、环境变量、启动命令 | Railway、Render、Fly.io | 后端 API、小型全栈项目 |
| 云服务器 | 操作系统、运行环境、Nginx、日志、备份 | 阿里云 ECS、腾讯云 CVM | 要自己控制环境,长期跑后端 |
| 容器部署 | 镜像、编排文件、部署脚本 | 云服务器 + Docker | 多个服务、多套环境 |
越往下,控制权越大,要你管的事也越多。第一天上线,选最快拿到地址的那种。控制权真的不够用了,再往下换。
餐厅后台用了三个托管平台,没有一台自己的服务器:前端放在 Vercel,后端 API 跑在 Cloudflare Workers,数据库用 Neon 托管的 PostgreSQL。
陪玩系统走的是另一条路:一台云服务器,用 Docker 跑起来。它有好几端,要自己管日志、反向代理和备份,托管平台不够用。它每次启动的顺序是固定的:先检查环境变量,再同步数据库结构,最后启动服务。环境变量缺一项,或者生产环境里某个开关没关,就直接退出,不带着残缺的配置跑起来。部署脚本还加了一把锁,同一时间只允许一次发布,免得两次发布互相覆盖。
各类平台的细节、域名解析和 HTTPS,见 服务器部署。
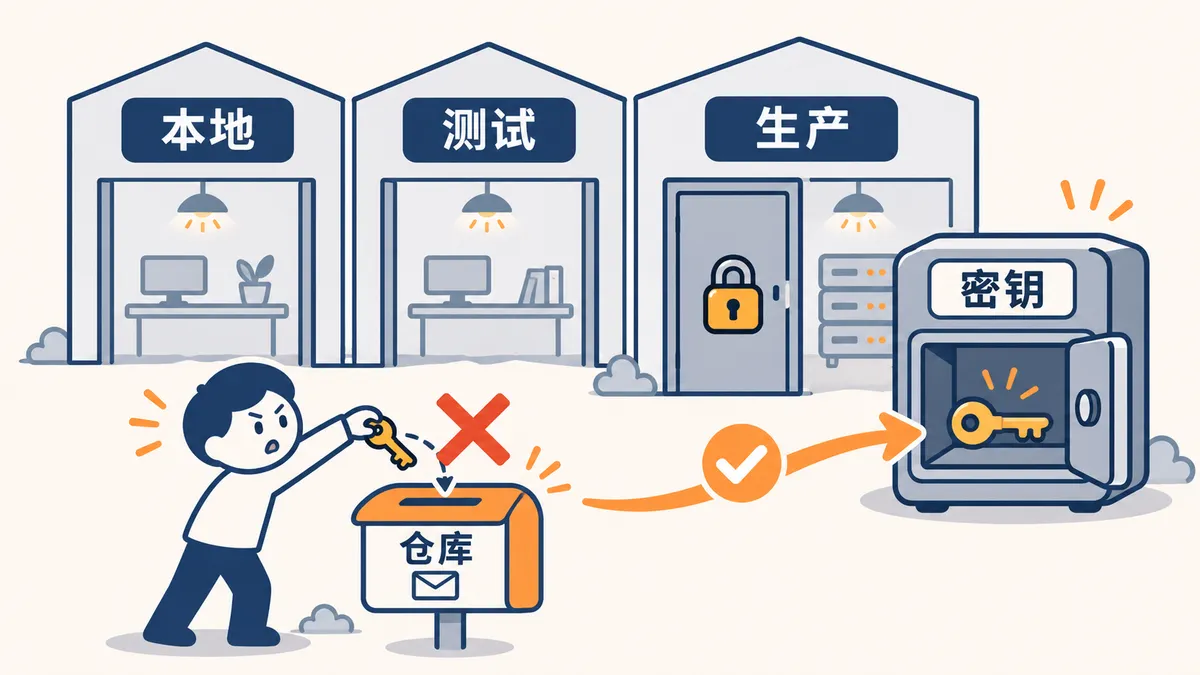
三个房间:本地、预览、生产
一个要长期运行的系统,至少有三套环境:
| 环境 | 谁在用 | 数据 | 能不能弄坏 |
|---|---|---|---|
| 本地 | 你和 AI | 假数据,随便造 | 随便 |
| 预览(也叫测试环境) | 你、同事、来验收的客户 | 假数据或脱敏数据 | 可以,修好就行 |
| 生产 | 真实用户 | 真实订单、真实的钱 | 不能 |
三套环境跑的是同一份代码,配置各不相同:连不同的数据库,用不同的密钥,开关的状态也不同。
餐厅后台的做法是:每开一个 PR,自动部署一个预览地址,审 PR 时直接点开看;PR 合并进 main,自动发布到生产。
分环境时,有三件事要你判断。
预览和生产不能共用数据库。 共用的话,你在预览环境里测一次删除,删掉的是真实数据。
清空数据的脚本不能在生产跑。 餐厅后台为了演示,有一个填充示例数据的脚本。它会先清空菜单、顾客、订单这些表,再写入 30 笔示例订单。在本地和预览环境,这很方便。在生产环境跑一次,所有真实订单就没了。这类脚本,要么在生产环境里禁止运行,要么干脆不部署到生产。
有些开关在生产必须关掉。 陪玩系统的生产配置里有两项:开放管理端访问、开放前台访问,都必须是 false。打开时,没登录的人也能进管理端,这是开发阶段图方便留的口子。它的启动检查会专门核对这两项,不是 false 就拒绝启动。
密钥为什么不能进仓库
密钥是能证明「我是谁」、能动钱或动数据的那串字符,比如数据库密码、支付平台的私钥、第三方服务的 API Key。
陪玩系统上线时,生产环境要配十几个变量。按性质分一下:
| 类别 | 例子 | 泄露的后果 |
|---|---|---|
| 普通配置 | 网站地址、两个访问开关 | 泄露没关系,填错了系统会出问题 |
| 连接串 | 数据库地址、Redis 地址 | 别人能直接读写你的数据 |
| 账号密码 | 超级管理员的用户名和密码 | 别人能登录后台 |
| 支付凭证 | 支付宝的应用私钥,微信支付的商户私钥和 API 密钥 | 别人能以你的商户身份调用支付接口 |
后三类都是密钥。陪玩系统的 README 写得很直接:敏感配置必须通过环境变量或密钥管理系统注入,不得写进前端代码或仓库里的明文文件。
私有仓库也不行。仓库会被克隆到很多台电脑上,会被 AI 读,以后可能被改成公开,构建日志也可能把它带出去。推上去过一次,就要当它已经泄露。删掉文件不够,历史记录里还在。泄露以后先去平台作废旧密钥,再清理仓库,这个顺序见 什么不能进仓库。
除了「别提交 .env」,还有两个容易漏的地方。
前端变量,所有人都看得见。 前端代码最后会下载到用户的浏览器里。像 NEXT_PUBLIC_、EXPO_PUBLIC_ 这类带公开前缀的变量,构建时会被直接写进前端代码。它们只能放 API 地址这类公开信息。密钥放进去,任何人打开浏览器的开发者工具都能看到。
存进 Secrets,不等于生产环境已经生效。 GitHub Secrets 只是把值安全地存在 GitHub 上。它要被流水线读取,传给部署脚本,写进服务器或平台的环境配置,再重启服务,才真的生效。验收时分三层看:流水线读得到;服务器或平台上的配置确实是新值;服务重启后,一条真实的业务路径能走通。详见 CI/CD 流水线。
餐厅后台的密钥分在三处:数据库连接串,用 Cloudflare 的命令行工具存进 Workers 自己的密钥配置;部署前端用的 Vercel 令牌,存在 GitHub Secrets 里;本地开发用的 .env,被 .gitignore 挡在仓库外面,仓库里只留一份填着假值的 .env.example。
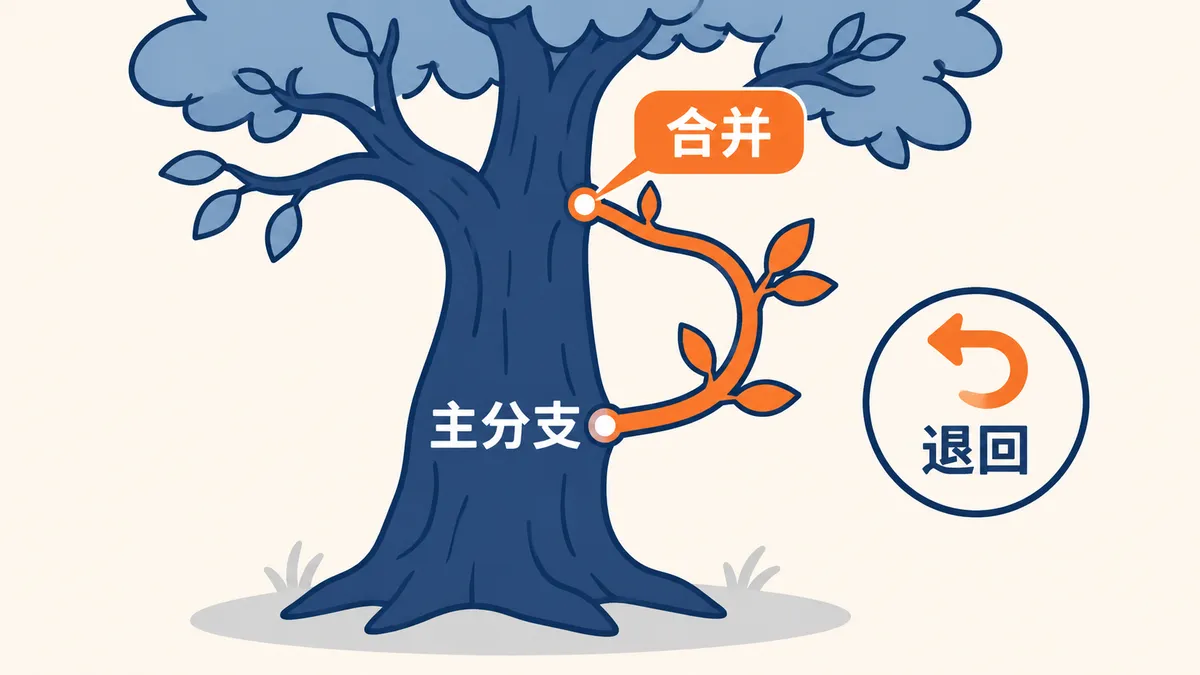
Git 保住每一步
上线以后,每一次改动都可能把线上弄坏。Git 的作用,是让每一步都能退回去。
具体操作见小课的 仓库和提交 和 分支和 PR。这里只列判断:
- main 就是线上那份代码。 不直接改 main。改动先在分支上做,开 PR,检查通过再合。
- 一个提交只做一件事。 出了问题,才能只退回那一件。
- 退回用
revert。 它新增一个反向提交,历史不丢。会删历史的命令,写进规则文件禁掉。 - 私有仓库的保护要不要买。 GitHub 免费账号下,个人私有仓库不能强制「改 main 必须走 PR」。要强制,得升级 Pro,目前每月 4 美元。不升级,就只能靠你和 AI 自觉,规则文件里一定要写清楚。
同时让几个 AI 并行做任务时,每个任务会有自己的工作目录。目录一多,最常见的事故是看目录名字猜它是哪条分支。一个名字里带 main 的目录,里面可能是一份落后很多的旧 main。我们出过一次这样的事故,最后下单用不了,系统几乎全部瘫痪。经过见 一次 worktree 认错主线,最后把系统打瘫的事故。
合并后自动发布
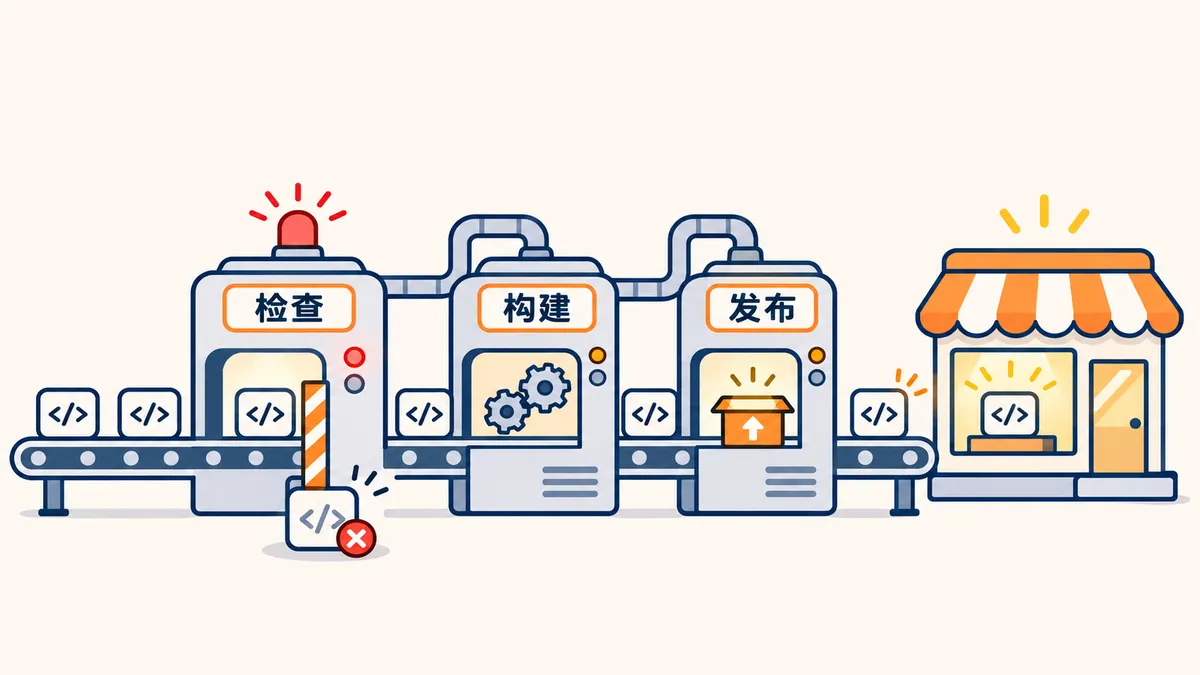
靠人记得「先测试、再构建、再上传」,迟早会漏一步。CI/CD 把这些动作写成固定流程。CI(持续集成)检查一次改动能不能进入下一步;CD(持续部署)把通过检查的版本发出去。
餐厅后台有两条流水线:
- 检查流水线:在 PR 和 main 上跑。先重新生成接口代码,检查它和仓库里的是否一致;再跑类型检查、测试、代码检查;最后构建前端。「检查一致」这一步,专门抓有人手改了自动生成的文件。
- 发布流水线:先跑一遍检查。在 PR 上部署预览地址;合并进 main 后,部署到生产。
这对应一个常见的分层:
| 阶段 | 什么时候触发 | 做什么 |
|---|---|---|
| PR 检查 | 开 PR、推新提交 | 装依赖、构建、测试 |
| 预览 | PR 检查通过 | 生成预览地址,审的人点开看 |
| 生产 | 合并进 main | 发布到线上 |
| 回滚 | 发布出了问题 | 退回上一个成功的版本 |
有了流水线,有一条纪律要守:线上出了问题,不要直接登录服务器改文件。那样会造出一个 Git 里找不到的版本,下次自动发布时,你的修改会被悄悄覆盖。该走的路是:本地复现,在分支上修,开 PR,合并后自动发布。
流水线红了怎么查、怎么省 Actions 的额度,见 Actions。
交给 AI 的
部署配置、流水线文件、环境变量模板,都可以交给 AI 写。下面这段可以直接发给它:
任务:把餐厅后台部署上线,并配好合并后自动发布。

部署方案:前端放 [静态托管平台],后端 API 放 [应用托管平台],数据库用 [托管 PostgreSQL]。

要求:
1. 分三套环境:本地、预览、生产。预览和生产用不同的数据库。
2. 列出每套环境需要的环境变量,标明哪些是密钥。仓库里只放 .env.example,值全部是假的;.env 加进 .gitignore。
3. 密钥只放在平台的密钥配置或 GitHub Secrets 里。前端公开变量里只放 API 地址,不放任何密钥。
4. 会清空数据的示例数据脚本,在生产环境调用时直接报错退出。
5. 服务启动前检查必需的环境变量,缺一项就报出变量名并退出。
6. 两条 GitHub Actions 流水线:PR 上跑类型检查、测试、构建,并部署预览;合并进 main 后部署生产。每个任务设超时。
7. 后端加一个健康检查接口,返回服务状态和当前版本号。
8. 写一份部署说明:第一次怎么部署、怎么加密钥、怎么回滚到上一个版本。

需要我在网页上操作的步骤(开账号、填真实密钥、绑域名),列成清单交给我,不要假设我已经做好。
最后一条一定要写。开平台账号、填真实密钥、改域名解析,只能你自己做。AI 看不到你做没做,容易当成已经做好了。
你要验收的
这一章的验收有三件事,每件都要你亲手做。
线上地址真的能打开。
- 用手机流量(不连你的 Wi-Fi)打开生产地址。首页能出来,地址栏是 HTTPS。
- 打开后端的健康检查地址,返回正常,版本号是你刚合并的那个。
- 打开浏览器开发者工具的「网络」面板,看前端请求打到的是线上 API 地址,不是
localhost。 - 在线上走一遍第 6 章(什么叫做完了)的演示路线:建一单,推进状态,看首页数字变化。
密钥没进仓库。
- 在 GitHub 网页上看仓库的文件列表,没有
.env。 - 让 AI 在整个 Git 历史里搜一遍密钥的变量名和常见密钥格式,把搜索命令和结果都给你看。
- 打开线上前端页面,在开发者工具里搜数据库地址、
KEY、SECRET,搜不到密钥的值。 - 在 GitHub 的 Secrets 页面,确认需要的名字都在;在托管平台上,确认预览和生产的数据库地址不一样。
改坏了能退回去。
- 演练一次:合并一个肉眼看得见的小改动,比如改一行首页标题。等自动发布完,确认线上变了。
- 用
revert撤销这个提交,走 PR 合并。等自动发布完,确认线上回到了原样。 - 记下从发现问题到线上恢复,一共花了几分钟。
这次演练只退了代码。数据库改坏了怎么办,发布出错时怎么比用户先知道,是第 8 章(上线后别出事)的事。
本章做完的样子
- 餐厅后台有一个正式的线上地址,任何人用手机都能打开。
- 本地、预览、生产三套环境分开,预览和生产用不同的数据库。
- 仓库里没有密钥,前端代码里没有密钥;会清空数据的脚本在生产环境跑不起来。
- 每个 PR 自动检查并生成预览地址,合并进 main 后自动发布到生产。
- 你演练过一次回退,知道恢复要几分钟。
这一步谁来做
| 交给 AI 的 | 你要判断和验收的 |
|---|---|
| 让 AI 配好部署、环境变量和自动发布。 | 线上地址真的能打开;密钥没进仓库;改坏了能退回去。 |
相关阅读
上一章:第 6 章 什么叫做完了 · 下一章:第 8 章 上线后别出事